
机房里三十七号工位亮着屏幕,编译器吐出第十七个报错,光标在终端里一闪一闪。旁边两台电脑空着,键盘上贴着占座的便利贴,主人不知道去了哪里。凌晨一点的实验室,只剩下敲键盘的声音和空调的嗡嗡声。
debug这件事,外行以为是找虫子,内行知道是在排查整条逻辑链。一个段错误可能来自指针越界,可能来自内存泄漏,也可能来自更上游一个不起眼的初始化遗漏。报错信息只告诉你哪断了,不告诉你为什么断。从看到报错到找到根因,中间要走的路,有时候比写代码本身还长。
报错就是起点
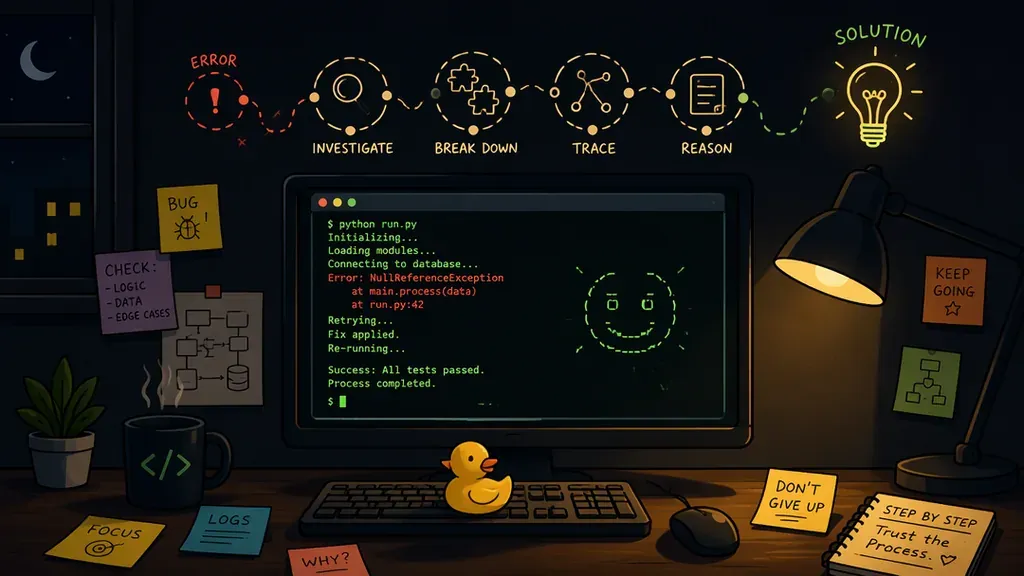
面对报错,最自然的反应是去看错误信息。但报错信息往往指向症状而非病因。比如一个空指针异常,真正出问题的可能是在三层之前某个该赋值的地方漏了一步。逐层回溯的过程,实际上是在重建程序的执行路径,把运行时状态和源码逻辑对上号。这个动作在认知科学里有个近似的说法叫心理模拟,即人在头脑中运行一段程序,预测每一步的状态变化。研究表明,有经验的程序员做心理模拟的准确率明显高于新手,差距主要在于他们能更快排除不可能的路径,缩小搜索范围。
断点设在哪,决定了排查效率
有经验的debug习惯是先设断点,而不是逐行看。断点的位置本身就是一种假设,假设错误发生在某个区间内。设得准,几次运行就能定位;设得不准,就得多绕几圈。这跟认知心理学里假设检验的框架高度一致,先提出假设,再用实验数据验证或推翻。debug就是一次微型科学实验,变量是输入数据,控制组是预期行为,实验组是实际行为,差异就是bug。
Bjork等人提出的desirable difficulties概念,恰好能解释为什么debug比抄代码学到的多。当认知过程遇到适度困难时,记忆编码更深、保持更久。逐行排查报错的过程强迫大脑把代码从能跑的层面拉到理解每一步在干什么这个层面,加工深度远超直接看答案。所以那些debug到凌晨的人,第二天对那段代码的记忆往往异常牢固。
橡皮鸭和解释的力量
机房角落有时候能看到一个人对着屏幕自言自语,或者在跟旁边的人讲,这个函数接收一个数组,按长度排序,然后返回前k个,讲到一半突然停住,等一下,排序前有没有判空?这种场景在程序员圈子里有个名字叫橡皮鸭调试法,对着一只鸭子把代码逻辑从头讲一遍,讲着讲着自己就发现了问题。背后的原理是生产效应,MacLeod等人在2010年的实验中发现,大声读出信息比默读能多记住约10%到15%的内容。生产过程迫使大脑对信息进行更深的语义加工,把模糊的直觉变成显式的语言表述,漏洞就暴露出来了。
这也能解释为什么小组debug往往比单人快。同伴未必更聪明,把思路说出来这个动作本身就在做认知整理。一个人闷头看代码,容易陷入固定视角,觉得自己的逻辑没问题。一旦开口解释,就必须把隐性假设变成显性陈述,那些想当然的地方就藏不住了。
跑通的那一刻
绿灯亮起来的时候,终端输出从一片红色变成Build Successful。跑通后大脑释放多巴胺,奖赏回路在起作用。Csikszentmihalyi描述的心流状态有个特征叫即时反馈,debug过程中每次运行都给出明确反馈,要么继续报错要么通过,这种高频反馈恰好是心流产生的条件之一。
跑通之后还有个变化,对整段代码的理解发生了质变。debug之前,代码是能跑的文本;debug之后,代码变成被验证过的逻辑模型。两者之间的差异,就是Bjork说的加工深度差异。信息被反复提取、重组、验证后,从工作记忆转移到了长期记忆,形成了更稳固的知识网络。
从报错到绿灯,走的是一条认知链
回看整个过程,从看到报错到程序跑通,大脑走过的路远比屏幕上那几行代码多。先做心理模拟重建执行路径,再用假设检验缩小排查范围,接着通过语言生产暴露隐性漏洞,最后在反馈循环中修正模型。每一步都对应认知科学里的一个机制,而这些机制共同指向同一个结论,困难本身就是深度学习的触发器。那些在机房熬到凌晨的人,拿走的不仅是正确的代码,还有一段被反复锤打过、大概率不会忘的逻辑。绿灯亮起来,屏幕上跑通的是代码,脑子里想通的是问题。


暂无评论