
在计算机科学的所有数据结构里,哈希表可能是日常开发中出场频率最高的一个。数据库索引、缓存系统、编程语言里的字典类型,底层几乎都依赖它。一个设计良好的哈希表,查找、插入、删除的平均时间复杂度都是O(1),也就是说无论存了一万条还是一亿条数据,单次操作的时间基本不变。这个效率怎么做到的,又付出了什么代价,值得弄明白。
数组的特点是知道下标就能直接访问对应位置,速度极快,但查找特定值需要从头遍历,数据量一大就慢。哈希表的做法是用哈希函数把键转换成数组下标,这样无论存了多少条数据,一次计算就能定位到存储位置。
哈希函数如何工作
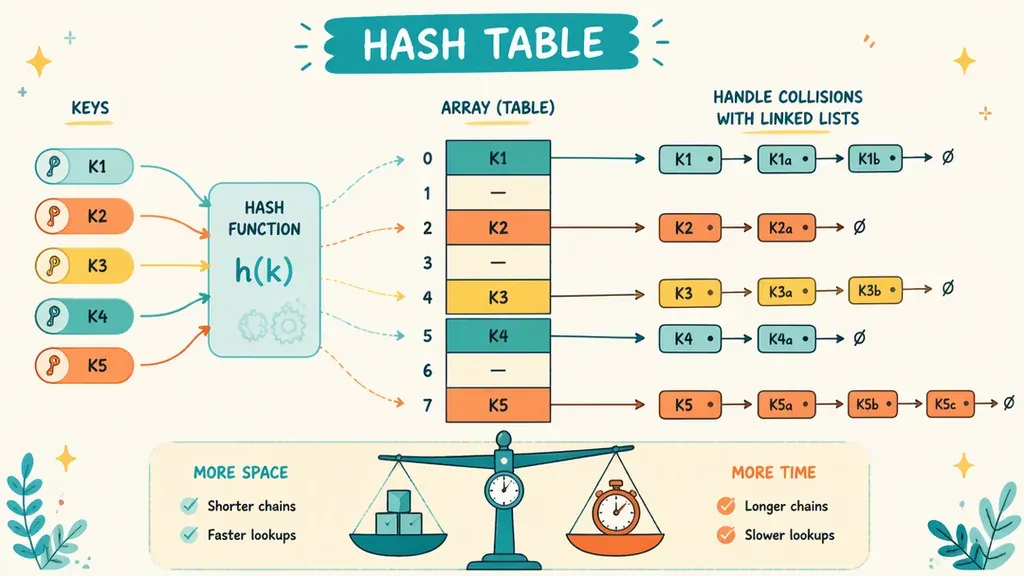
哈希函数的工作可以分成两步。第一步,把键(可能是字符串、数字、对象)映射成一个整数,通常用取模运算限制在数组大小范围内。比如数组长度16,哈希值对16取模,结果一定落在0到15之间,正好对应数组下标。理想情况下,不同的键会均匀分散到不同位置,互不干扰。
但理想情况几乎不存在。不同的键经过哈希计算后可能映射到同一个下标,这就是哈希冲突。冲突是数学上的必然,把无限可能的输入压进有限数量的桶里,根据鸽巢原理,也叫抽屉原理,冲突迟早会发生。
冲突处理的两种主流方案
链地址法的做法是每个数组位置存一个链表,冲突的元素挂在同一个链表上。查找时先算出下标,再在链表里逐个比对。只要冲突不严重,链表很短,效率依然很高。
开放地址法不使用链表。冲突后按某种规则试探下一个空位。线性探测是最简单的形式,当前位置已经存了元素就往后挪一格,直到找到空位。这种方法对缓存更友好,但对删除操作处理更复杂,需要在查找时跳过被标记为已删除的槽位。
两种方案各有取舍。链地址法实现简单、对扩容不敏感,但链表节点分散在内存各处,缓存命中率低。开放地址法数据紧凑、缓存友好,但负载高时性能下降更快。Java的HashMap用链地址法,JDK 8之后链表长度超过8会转成红黑树;Python的dict用开放地址法。具体选哪种,要看场景的性能需求和工程取舍。
负载因子与效率的临界点
负载因子定义为元素数量除以数组长度,反映哈希表的拥挤程度。负载因子越高,冲突概率越大,查找链表越长,效率越低。负载因子越低,空间浪费越多。
实际工程中通常设一个阈值,比如0.75。当负载因子超过阈值,触发扩容,分配一个更大的数组(通常翻倍),把所有元素重新哈希放进去。这个rehash过程是O(n)的,发生在单次插入时会导致延迟突增。这也是哈希表的典型代价,平均O(1),但最坏情况可能退化到O(n)。
从理论到工程的几个细节
哈希函数本身的设计是另一个关键。一个好的哈希函数需要满足两点,计算快,分布均匀。密码学领域的哈希函数如SHA-256追求抗碰撞,计算复杂但分布很好。非密码学场景的哈希函数如MurmurHash、xxHash更追求速度和分布质量的平衡。
另外有个安全问题容易被忽略。如果攻击者能预测哈希函数的输出分布,可以构造大量冲突键,把哈希表退化成链表,造成性能攻击。这种攻击叫哈希碰撞DoS。Python 3.3之后引入了哈希随机化,每次启动时加入随机种子,让同样的键在不同进程中哈希到不同位置,堵住了这个漏洞。
哈希表的故事说到底就是工程中反复出现的权衡模式,用空间换时间,用预计算换运行效率,用更高的实现复杂度换更好的平均性能。理解这个数据结构,仅记住O(1)这个结论远远不够。更重要的是看清一个工程方案如何用数学工具解决现实约束,以及效率背后那些默默接受的代价。


暂无评论